Fable 5.2 实测:慢,但测得狠
2026 年 11 月 16 日晚实测,云电脑上的 Cursor CLI,模型 claude-fable-5-2-high,对照 claude-opus-5-5-high
同一道题,Opus 5.5 十分半钟就交卷了,Fable 5.2 跑了 37 分钟,最后还断了一次线,不过翻它的测试,491 个,比 Opus 的 217 个多一倍还多。
题是我自己出的,从零写一个迷你电子表格,要有公式解析、依赖重算、循环引用检测、命令行,再加一个能点着改的网页,只许用 Python 标准库,两个模型拿同一份 TASK.md,同一句话开跑,中间不插手,验收用我另外写的 44 个测试,它们看不到。
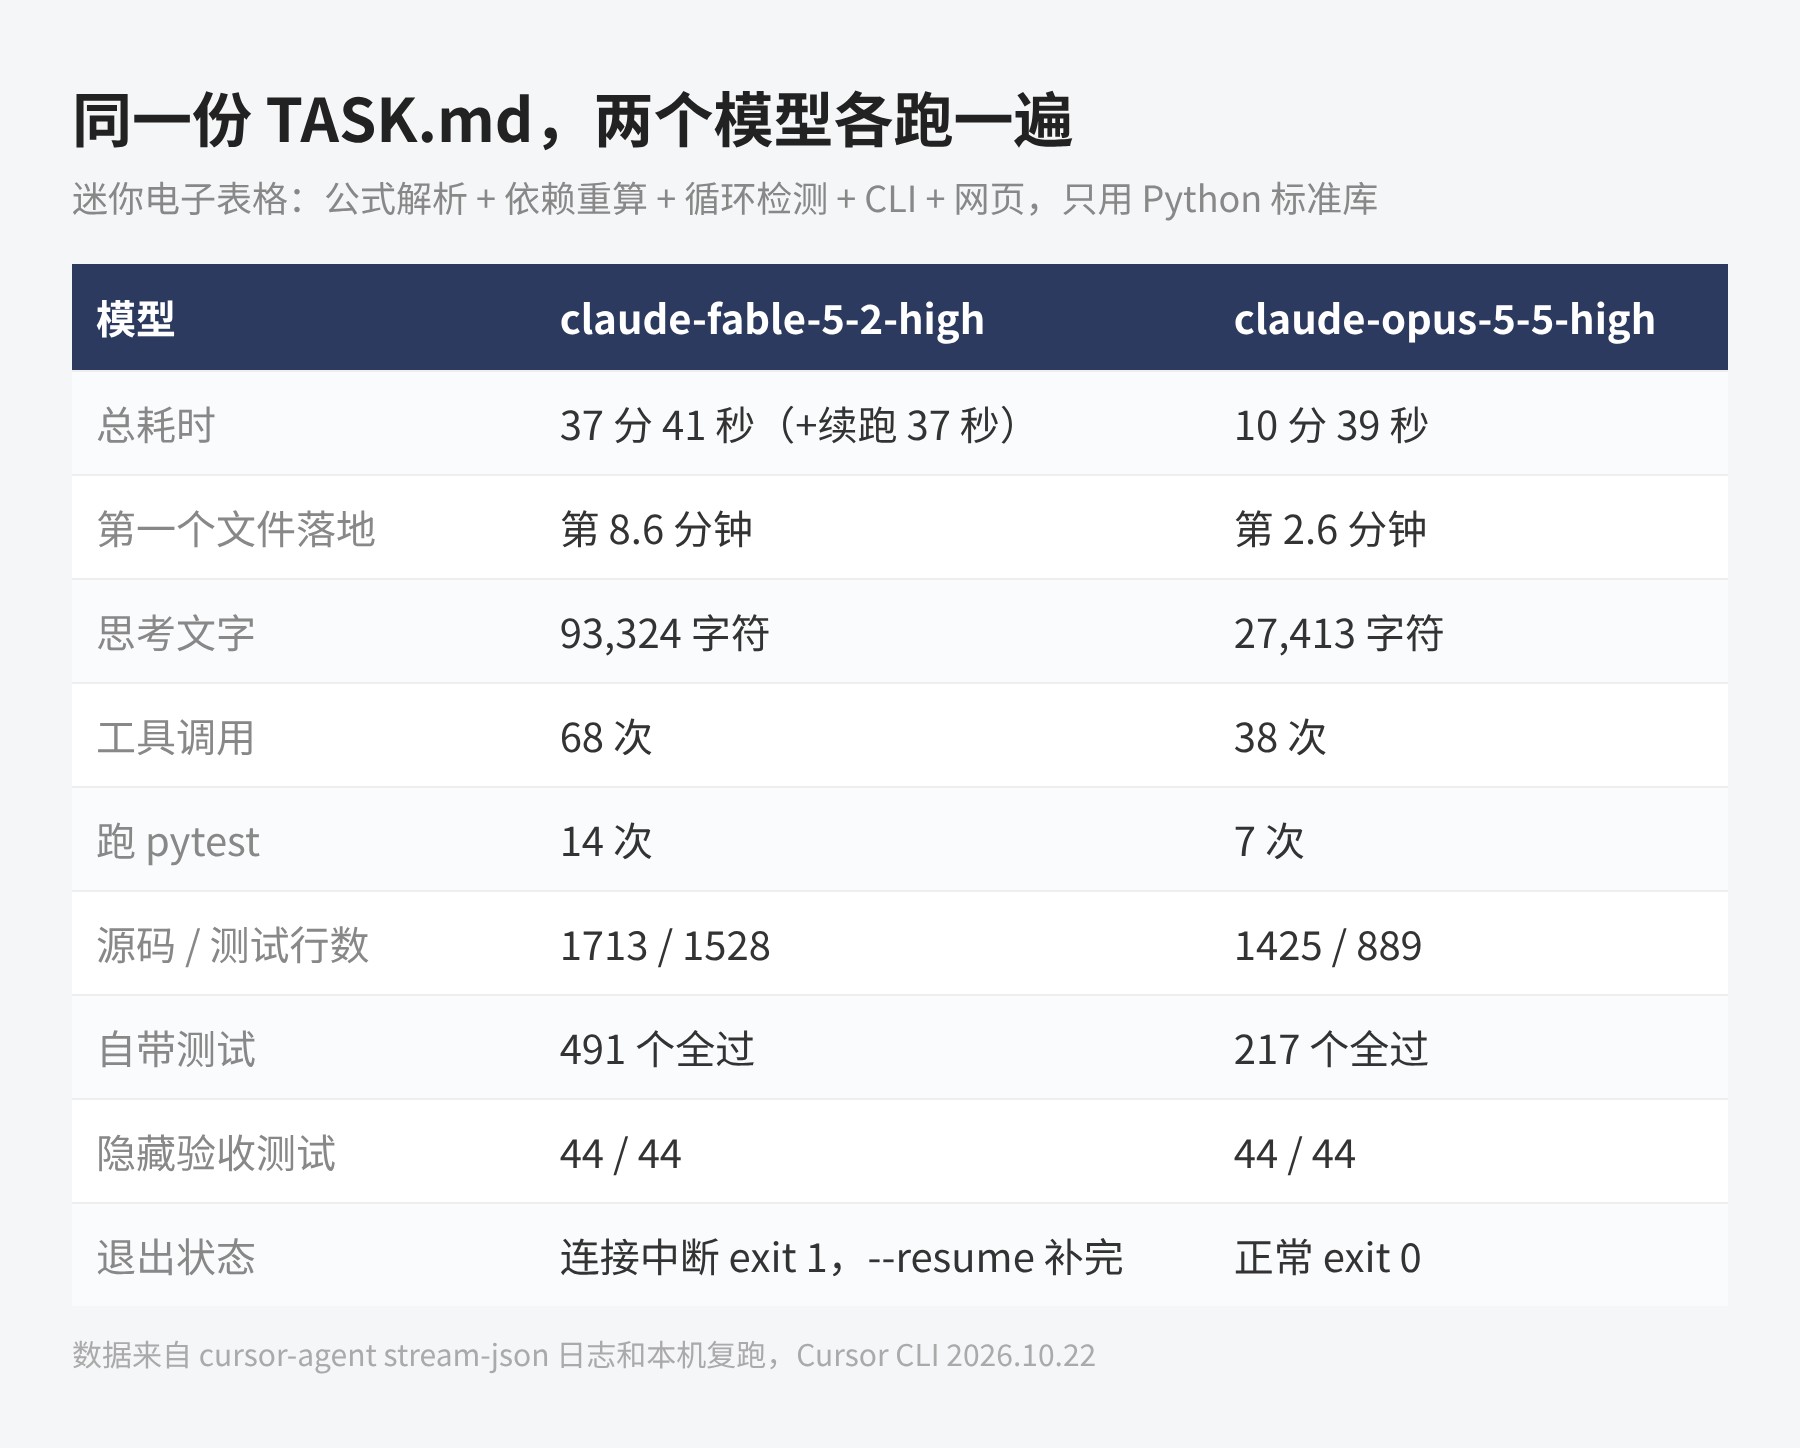
▲ 两边的真实记录,耗时、工具调用、代码行数和测试结果都在这张表里
先说结果,44 个隐藏测试两边都全过,网页我用无头浏览器点进去改了个单价,小计都跟着变了,又压了一下,两万五千多格串成一条长链,两边都没栈溢出,这道题算是都做对了。
差别在过程,Fable 开头闷头想了 8 分半才写第一个文件,Opus 是 2 分半,Fable 整个过程一句话都没跟我说,日志里只有思考和工具调用,思考的字数是 Opus 的三倍多。
多出来的时间花哪了,翻日志还挺有意思,它写了 100 组随机编辑,每改一次就拿增量重算的结果跟从头算一遍逐格对比,还自己做了一轮变异测试,故意把依赖图代码改坏 6 处,看测试能不能抓到,抓到了 4 处。
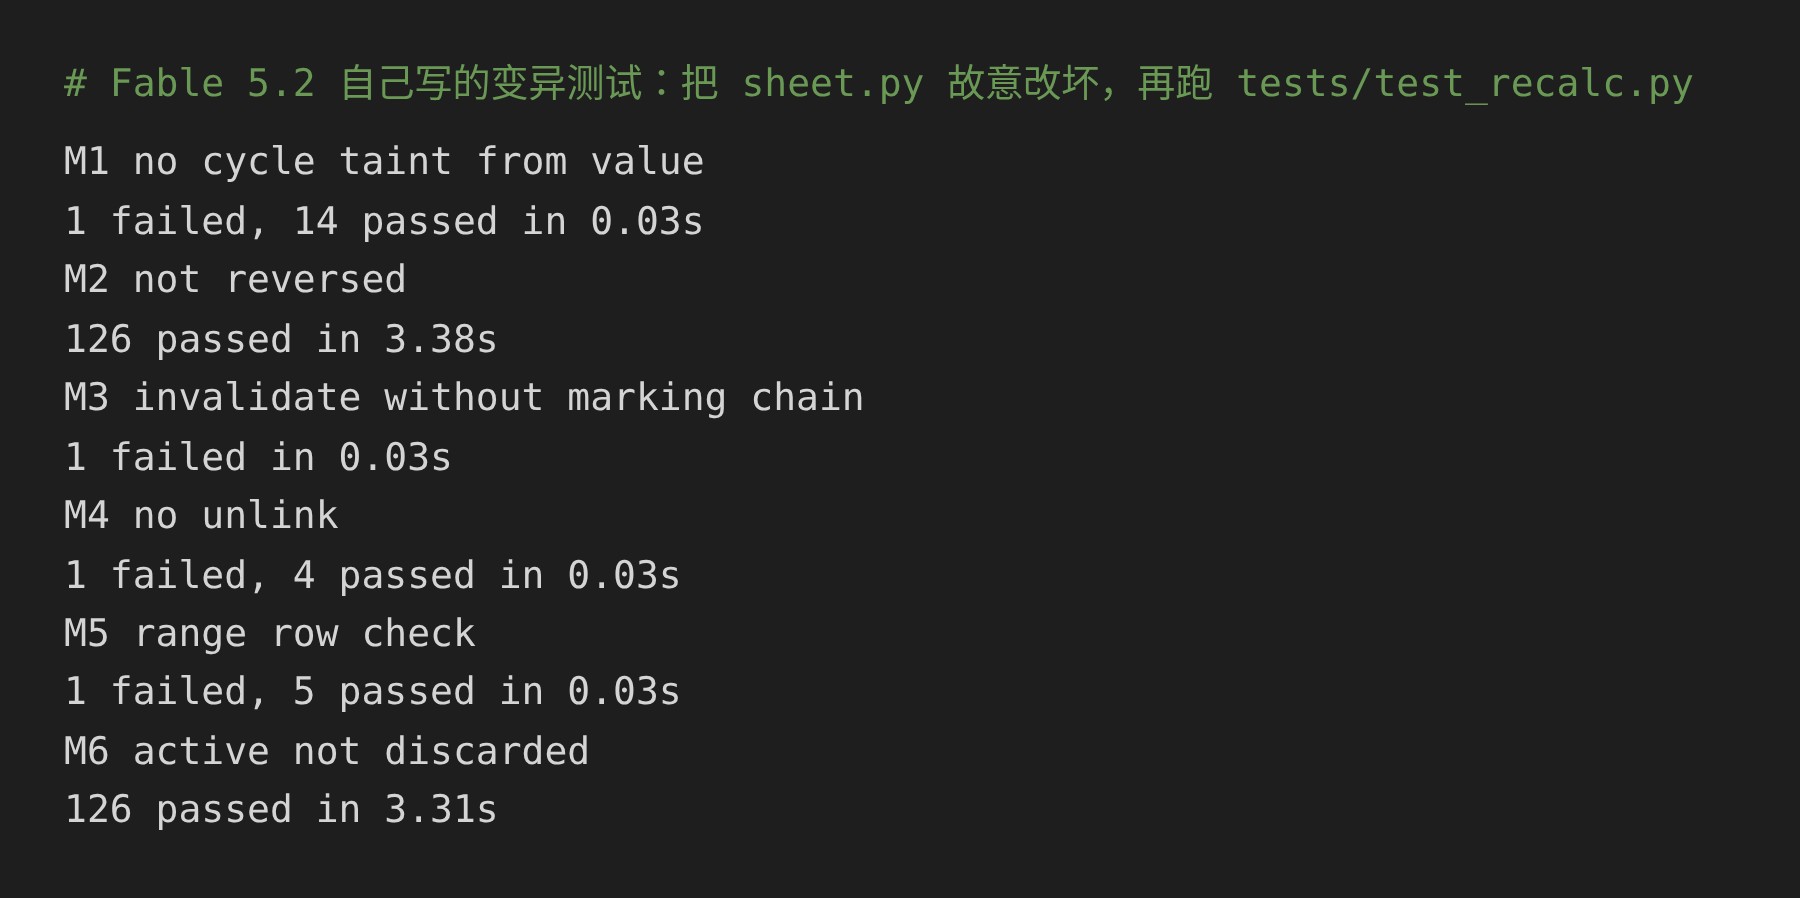
▲ Fable 自己跑的变异测试,改坏 6 处,有 4 处让测试失败
翻车也有,最后跑测试时连接卡住,命令行退出码 1,总结没给出来,我用 resume 接上,它花 37 秒复核了一遍才交了总结。另外第一次开跑我是后台起的,没关标准输入,两个进程挂了两分钟没输出,加上重定向才好,这个是 CLI 的坑,跟模型没关系。
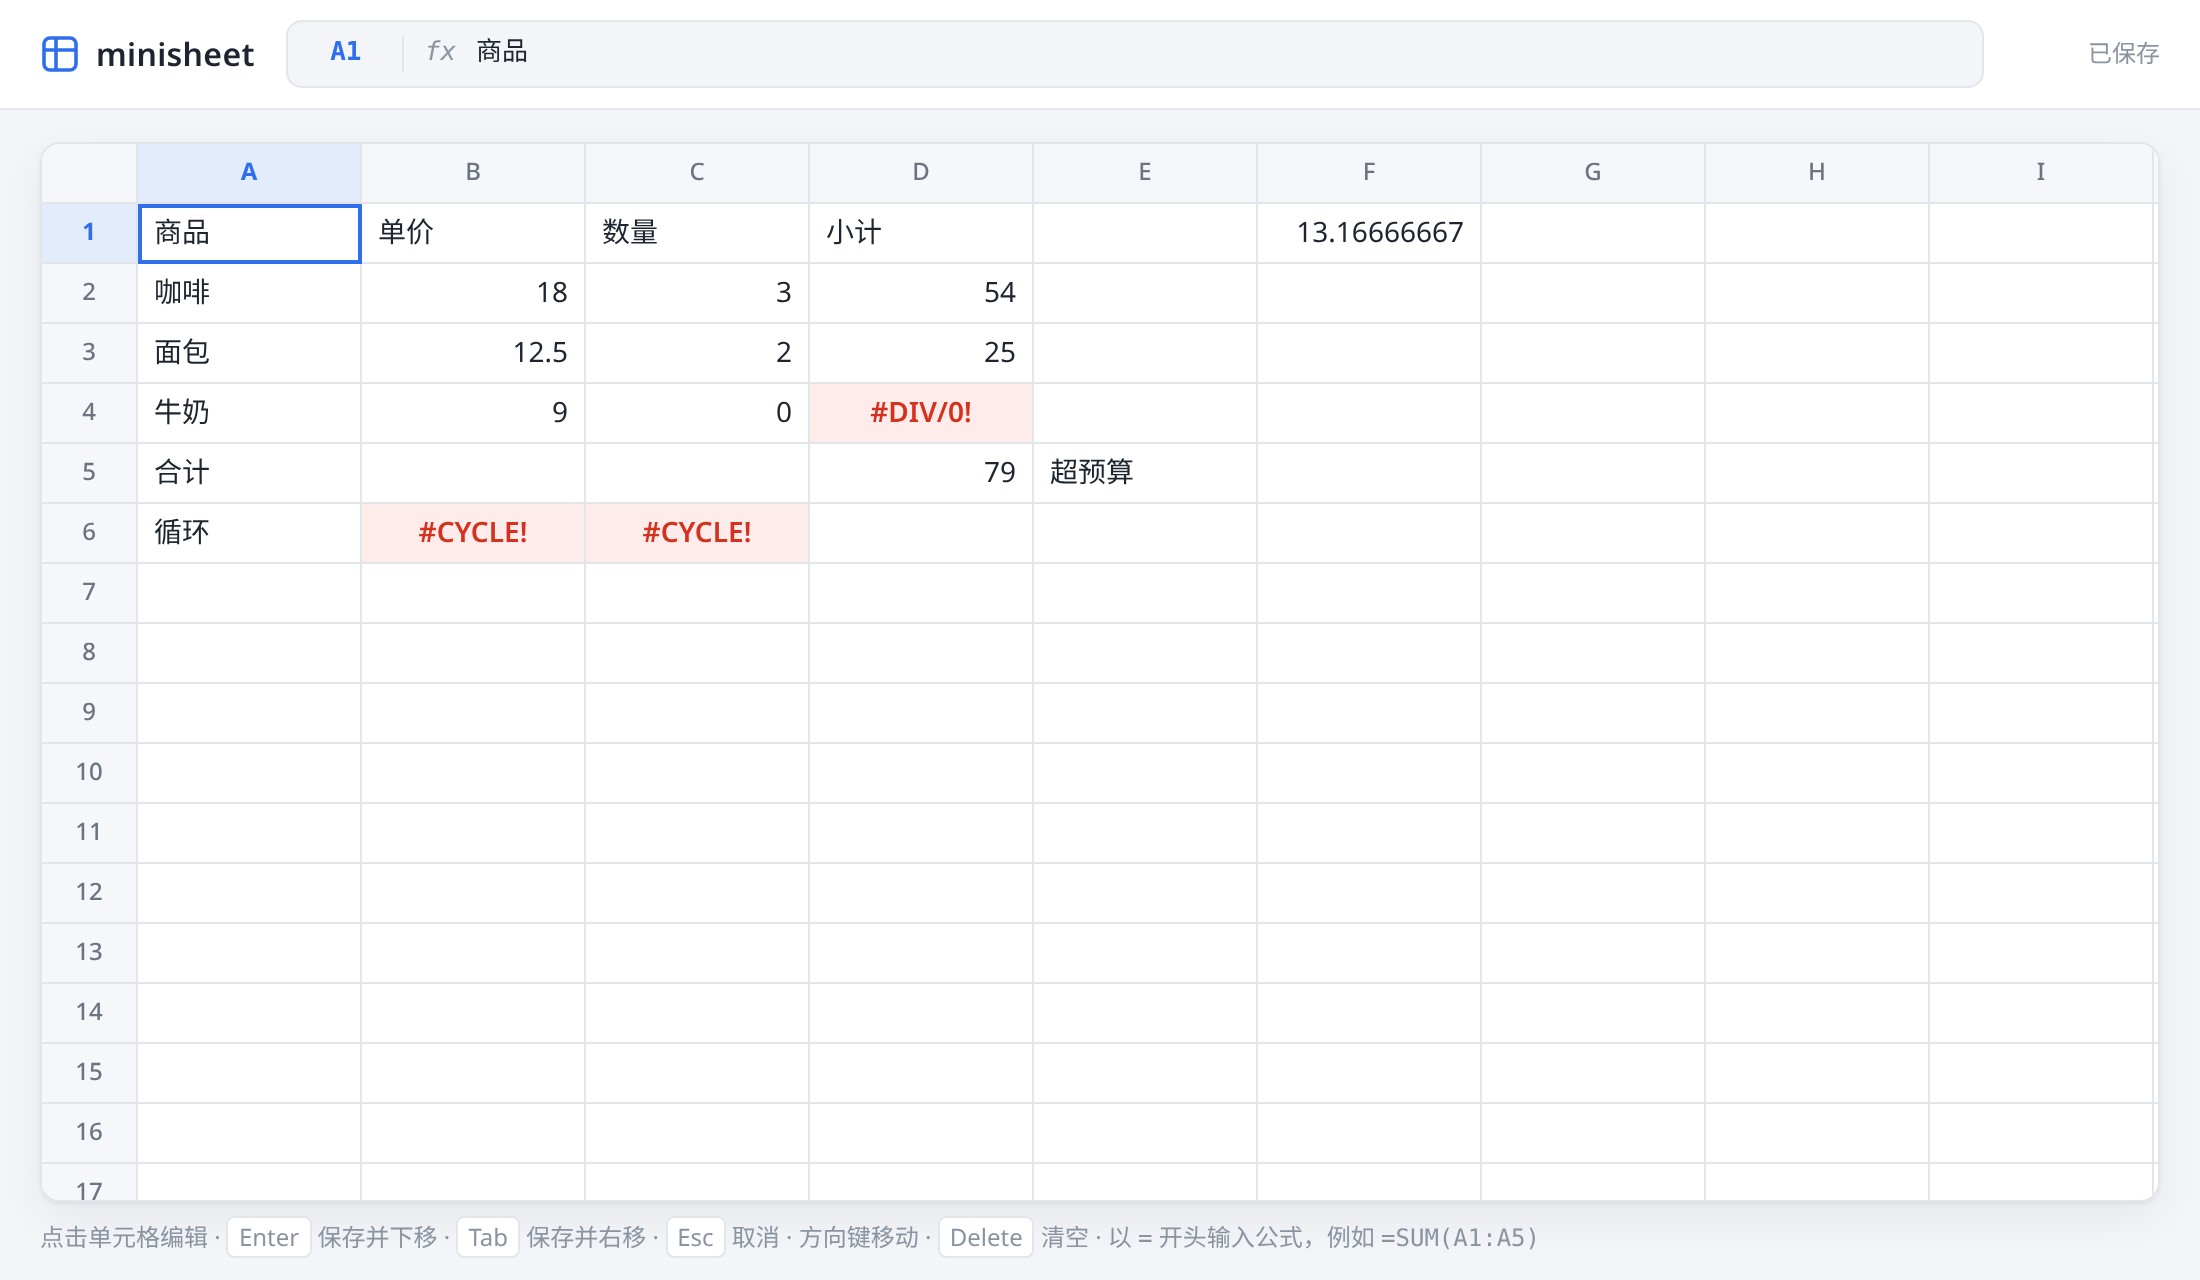
▲ Fable 写的网页,除零和循环引用标红,合计超过 70 就显示超预算
规格没写到的地方,两边各自拿了主意,比如 IF 没选中的分支里有循环引用,Fable 照常算值,Opus 直接判循环,两种都说得通,它们也都在总结里主动列出来了,这点挺好的。
我自己的感觉,日常改代码要快,Opus 5.5 就够用,十分钟出活,需求长、边界多、又没空盯着的活,可以丢给 Fable 慢慢磨,回来看测试就行。
- 题目先写成规格文件,自己再留一份它看不到的验收测试
- 后台跑 cursor-agent 记得把标准输入重定向到 /dev/null
- 长任务用 stream-json 存日志,断了还能 resume 接着跑
你们拿 Fable 5.2 跑过什么活,评论区说下。